BUSINESS PROCESS MANAGEMENT
Vous avez trouvé cela utile ? Partagez-le avec vos collègues.
L’adoption de l’IA commence par la compréhension de son impact
Presque toutes les équipes dirigeantes mènent actuellement une conversation similaire, prises entre un conseil d’administration qui réclame une stratégie en matière d’IA et des concurrents qui présentent déjà leurs propres projets pilotes. Pendant ce temps, les collaborateurs ont discrètement commencé à utiliser des outils qui n’ont reçu aucune validation officielle, avançant plus vite que ne pourrait jamais le faire le moindre déploiement institutionnel. Derrière tout cela se cache une pression dont peu de gens parlent ouvertement : la crainte d’être l’organisation qui a avancé trop lentement.
Cette crainte est légitime, mais elle pousse les organisations à se focaliser sur le mauvais objectif. 88 % des collaborateurs utilisent déjà l’IA au travail, mais seuls 5 % l’utilisent d’une manière qui transforme réellement leur façon de travailler. Et les chiffres sont encore plus révélateurs : 85 % des entreprises ont augmenté leurs investissements dans l’IA l’année dernière, tandis que seules 6 % ont vu ces investissements porter leurs fruits en moins d’un an. Le problème n’est donc pas l’adoption. Presque tout le monde adopte l’IA. La difficulté réside dans la capacité à transformer cette adoption en valeur mesurable.
La réussite de l’adoption de l’IA dépend de ce que la technologie change réellement une fois qu’elle est intégrée dans l’organisation. Elle modifie la manière dont le travail est réalisé et les données auxquelles on accède. Elle fait intervenir de nouvelles applications et introduit de nouveaux risques. Elle change la nature des responsabilités associées au résultat final. La direction souhaite savoir où l’IA crée une véritable valeur ajoutée et où elle peut réellement transformer le travail. Pour répondre à ces questions, il faut d’abord être capable d’identifier clairement les changements qu’elle entraîne.
Ainsi, avant de pouvoir gouverner ou déployer l’IA à grande échelle, une organisation doit pouvoir répondre à une question très concrète : quels processus, quelles tâches, quels rôles, quelles données, quelles applications, quels risques et quels contrôles l’IA affecte-t-elle réellement ? Une fois cette visibilité acquise, l’adoption de l’IA devient quelque chose que l’on peut piloter. Sans cette visibilité, on risque de déployer à grande échelle quelque chose que l’on ne maîtrise plus.
L’adoption de l’IA devient maîtrisable dès lors que les organisations peuvent voir ce qu’elle change à travers l’ensemble de l’organisation.
Un inventaire de l’IA ne suffit pas
Demandez à la plupart des organisations où elles en sont réellement avec l’IA aujourd’hui, et elles vous présenteront probablement une liste. Quelqu’un recense tous les outils utilisés par les collaborateurs et tous les projets pilotes en cours, puis présente cette liste à la direction comme une preuve de l’état des lieux : une série d’activités bien connues, désormais réalisées d’une manière nouvelle, façonnée par l’IA.
Cela donne l’impression d’un progrès, car la liste s’allonge chaque mois et, en apparence, tout semble positif. Mais la question de savoir si ces initiatives sont réellement efficaces, sûres ou capables de résoudre un problème concret reste souvent sans réponse. La liste s’allonge, un projet pilote fonctionne, une démonstration donne de bons résultats, et une logique implicite finit par s’imposer : l’introduction de l’IA devient en elle-même une réussite, plutôt que le point de départ d’une question plus difficile. Le travail est-il réellement devenu plus efficace, ou simplement plus rapide en amont tandis que quelqu’un doit discrètement corriger les résultats en aval ? Les données restent-elles là où elles devraient être ? Une démonstration n’a jamais été conçue pour répondre à ces questions, et une simple liste d’outils ne le peut pas davantage.
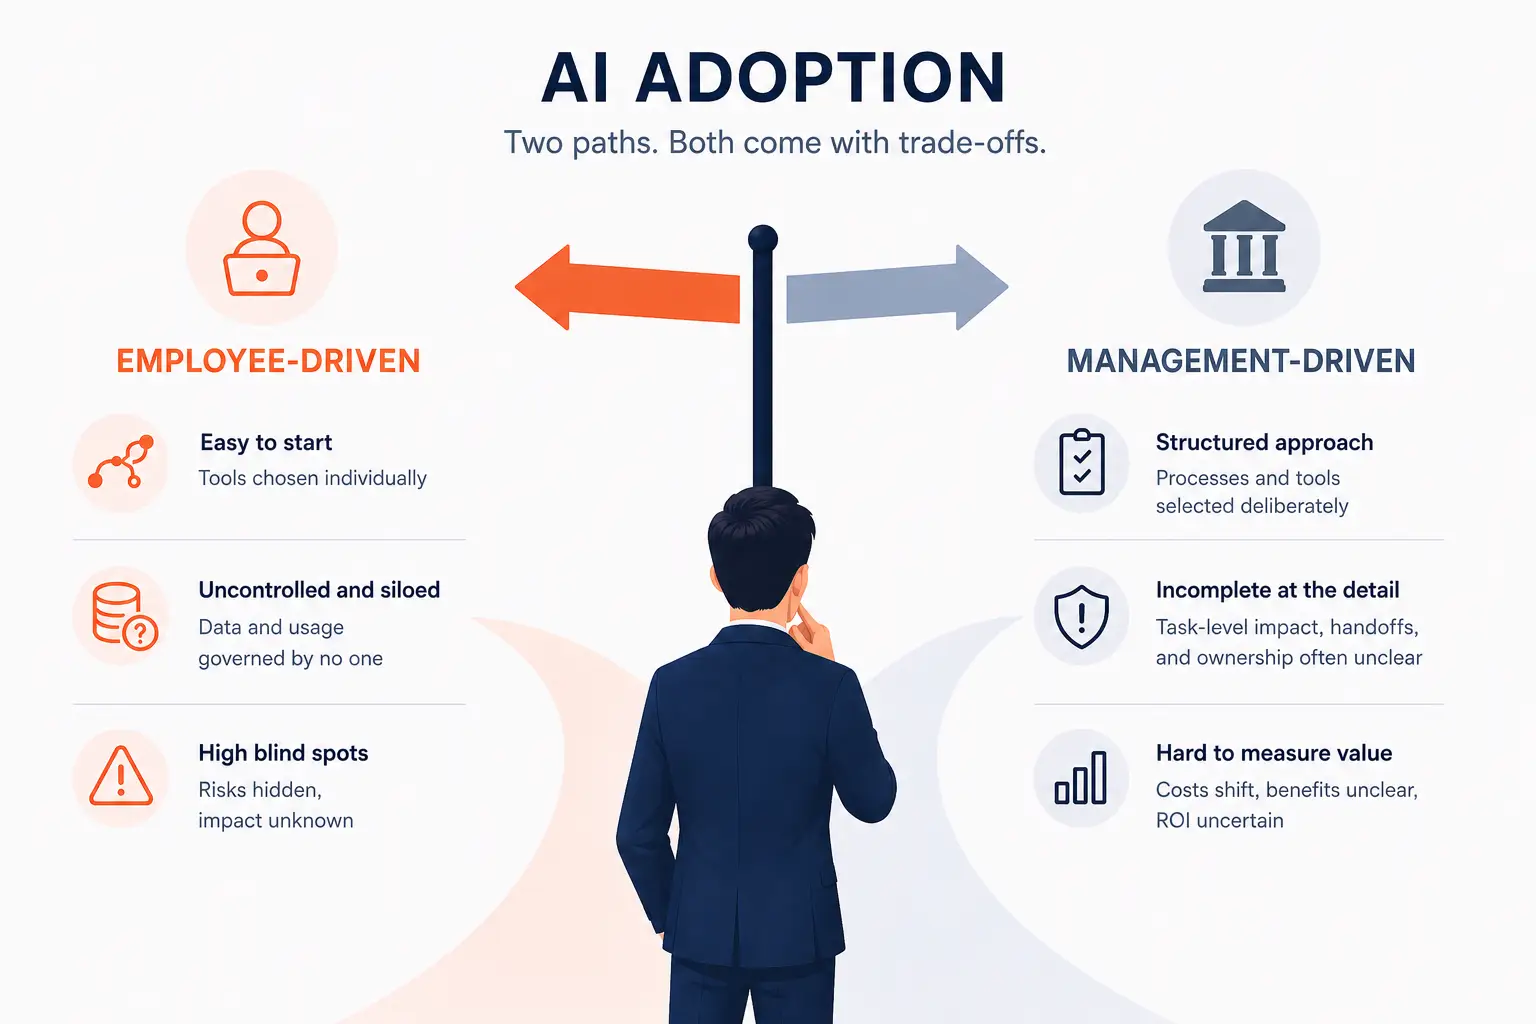
Pour comprendre pourquoi, observez comment l’IA s’introduit dans l’organisation au départ. Deux grands facteurs sont principalement à l’œuvre :
Facteur n° 1 : les collaborateurs automatisent eux-mêmes leur travail
Ce qui fonctionne. L’introduction de l’IA se fait de manière très simple, directement dans le travail quotidien. Les collaborateurs ont des tâches à accomplir et cherchent naturellement des moyens de les simplifier et de les accélérer, d’autant plus que les outils sont désormais accessibles en quelques clics et qu’il faut très peu de temps pour les essayer. Lorsqu’ils trouvent un outil adapté, ils commencent à l’utiliser.
Prenons l’exemple d’un service client. Les réclamations affluent toute la journée, et chacune nécessite une prise de décision. Certaines demandent simplement une clarification, d’autres nécessitent un remboursement. Les cas les plus sérieux sont transmis au service juridique. Un collaborateur s’inscrit alors au dernier outil d’IA à la mode et télécharge quelques fonctionnalités prêtes à l’emploi proposées par la communauté. Il connecte ensuite l’outil à la boîte de réception des réclamations. L’IA lit le message, consulte l’historique du compte pour obtenir davantage de contexte, puis suggère la marche à suivre. C’est plus rapide qu’un traitement manuel et le résultat est correct la plupart du temps. Le service continue donc à utiliser l’outil.
Progressivement, cette pratique devient la nouvelle manière standard de travailler. L’équipe s’y habitue et commence à étendre son utilisation à d’autres tâches, qui semblent elles aussi être réalisées plus rapidement. Cela donne l’image de collaborateurs utilisant efficacement l’IA — ce que toute organisation souhaiterait naturellement encourager.
Ce que cela coûte. Parce que la solution fonctionne, elle se diffuse sans véritable contrainte : il n’existe ni règles précisant quelles applications sont autorisées, ni directives indiquant quelles données peuvent être communiquées à ces outils en toute sécurité. Chaque collaborateur définit donc sa propre manière d’adopter l’IA, en dehors de tout cadre officiel. L’entreprise perd ainsi la capacité de savoir quels outils d’IA soutiennent désormais ses processus métier et, avec elle, toute possibilité réelle de garantir la stabilité et la conformité de ces processus.
Revenons au service client. La configuration semble suffisamment efficace pour que les collaborateurs connectent directement l’outil au système de gestion de la relation client et cessent de vérifier chaque résultat individuellement. Les données clients sont désormais transmises à un fournisseur d’IA que l’organisation n’a jamais évalué, dans le cadre de conditions que personne n’a lues. Personne n’a même déterminé combien de temps ces données seraient conservées, ni vérifié leur traitement au regard des obligations auxquelles l’organisation est soumise. L’IA bénéficie donc d’un accès autonome à un processus client, sans aucun dispositif de contrôle.
L’approche initiée par les collaborateurs mérite d’être reconnue pour son caractère naturel et spontané. Mais les personnes qui l’introduisent cherchent d’abord à résoudre leurs propres problèmes de charge de travail. Elles n’adoptent pas nécessairement un outil à l’échelle de l’organisation dont les questions de responsabilité et de conformité auraient déjà été prises en compte. Derrière un processus plus rapide grâce à l’IA se cache une adoption cloisonnée, pilotée individuellement par les collaborateurs. L’organisation se retrouve sans visibilité sur ses processus et exposée à des risques allant de la fuite de données aux violations des exigences de conformité.
Facteur n° 2 : la direction impose l’adoption de l’IA
Ce qui fonctionne. Le deuxième facteur vient de la direction. La pression visant à accroître l’efficacité et à réduire les coûts ne disparaît jamais vraiment. Lorsqu’une technologie promet de répondre à ces deux objectifs, elle attire rapidement l’attention. La direction mène ses propres recherches pour déterminer où l’IA pourrait être utile et observe ce que déploient les concurrents. Lorsque les initiatives d’un concurrent semblent porter leurs fruits, la pression s’intensifie encore. En examinant l’ensemble du paysage des processus de l’organisation, la direction peut identifier les processus métier fortement sollicités auxquels l’IA pourrait apporter un soutien, ainsi que les domaines offrant des possibilités de gains d’efficacité ou de réduction des coûts liés aux tâches manuelles.
Supposons une nouvelle fois que le service client soit retenu parmi les candidats. C’est un bon choix : le volume d’activité est important, le travail demande du temps et les collaborateurs suivent des procédures relativement bien définies. La direction valide l’initiative, les applications d’IA sont évaluées et sélectionnées avec soin, conformément aux exigences de conformité. L’IA est ensuite intégrée au processus métier et les collaborateurs disposent du temps nécessaire pour apprendre à l’utiliser. Dans cet environnement favorable, l’outil semble réellement permettre au service client de traiter les demandes plus rapidement.
Par rapport au premier scénario, il s’agit d’une amélioration majeure. Le processus a été sélectionné pour des raisons que l’on peut justifier, l’outil a été évalué avant d’être utilisé et quelqu’un a décidé d’investir véritablement du temps et des ressources dans cette initiative. Même si cette approche semble idéale, c’est précisément à ce stade que les difficultés commencent.
Ce que cela coûte. Une vision globale des processus permet à la direction d’identifier les bons candidats, mais une mise en œuvre correcte nécessite d’examiner de plus près les spécificités de chaque tâche : quelles applications lui sont associées ? Quelles données utilise-t-elle ? Chaque tâche comporte également ses propres risques, qui doivent être évalués individuellement. Sans cette évaluation, le fait de valider l’adoption de l’IA pour un processus laisse encore de nombreuses incertitudes quant à la manière dont chaque tâche doit réellement fonctionner. Quand l’IA doit-elle fonctionner de manière entièrement autonome ? Quand une intervention humaine doit-elle être prévue ? Comment doit s’effectuer le passage d’une tâche exécutée par l’IA à une autre ? Ce sont ces détails qui déterminent si le processus a été suffisamment évalué pour permettre une introduction appropriée de l’IA.
Revenons au service client. L’outil a fonctionné parce que le projet pilote avait été conçu pour réussir. Il a été déployé dans un service disposant du temps et des ressources nécessaires pour introduire correctement l’IA, sur un périmètre limité de cas, avec une équipe motivée qui corrigeait activement les problèmes rencontrés. Dans cet environnement favorable, quoique quelque peu artificiel, l’outil a pu faire ses preuves et le déploiement a semblé largement réussi. Les collaborateurs vous diraient probablement que le processus fonctionne désormais mieux. Mais il est difficile de mesurer précisément dans quelle mesure il s’est amélioré, et aucune des conditions qui ont permis sa réussite ne subsiste nécessairement lorsque l’outil est déployé à grande échelle.
En général, lorsque l’IA est introduite de cette manière, le coût du processus avant et après sa mise en œuvre n’est jamais documenté. Il n’existe donc aucune base de comparaison. L’organisation doit se contenter de témoignages affirmant que l’outil permet de gagner du temps. Ce qui échappe à cette analyse, c’est que le coût de l’IA ne se limite presque jamais à la facture visible. Il comprend le modèle lui-même, l’infrastructure nécessaire, l’orchestration, la maintenance lorsqu’un fournisseur modifie ses services, ainsi que le temps consacré au contrôle humain — précisément celui que l’outil était censé supprimer. C’est la raison pour laquelle 42 % des organisations déclarent ne même pas être en mesure d’évaluer le retour sur leurs investissements dans l’IA. L’économie réalisée en amont du processus peut donc être silencieusement compensée par des coûts supplémentaires en aval. Sans données chiffrées, personne ne voit ce transfert. Personne n’a non plus évalué si le gain obtenu justifie le risque de conformité supplémentaire et l’incident qu’il pourrait provoquer. Et une autre question n’a tout simplement pas été posée : qui est responsable de la tâche effectuée par l’IA lorsqu’elle fonctionne de manière autonome, et qui en assure la responsabilité lorsque la personne qui l’a mise en place quitte l’organisation ?
Ces mêmes éléments constituent la base nécessaire pour évaluer le retour sur investissement. Sans eux, il est difficile de déterminer ce que l’IA a réellement apporté : les tâches sont-elles devenues moins coûteuses et plus rapides, ou ont-elles au contraire augmenté en temps ou en coût ? Il est tout aussi difficile de savoir si une partie du travail a simplement été transférée discrètement à un autre service. Ce qui semble en surface être une accélération maîtrisée laisse donc subsister des lacunes qui n’ont jamais été évaluées. Certaines tâches sont exécutées sans supervision et certains coûts restent invisibles. L’organisation supprime un type de travail tout en en créant un autre, sans pouvoir déterminer lequel des deux est le plus important.
Deux points de départ différents — une approche ascendante et une approche descendante — mais la même conclusion : l’IA est déjà présente dans l’organisation, et personne ne peut dire exactement ce qu’elle y fait. La question est de savoir : où faut-il regarder ?
L’impact réel se manifeste au niveau du processus
Chaque processus métier n’est en réalité qu’une chaîne de tâches. Chacune est réalisée par quelqu’un, s’appuie sur certaines données, utilise un ou plusieurs systèmes et comporte son propre niveau de risque. C’est à ce niveau que l’IA laisse réellement son empreinte, tâche par tâche. Certaines tâches sont simplement assistées, d’autres accélérées, automatisées ou presque entièrement confiées à l’IA.
« Nous utilisons l’IA dans les processus du service client » est un slogan. « Dans le processus de traitement des réclamations, la tâche d’évaluation de la gravité est désormais assistée par l’IA, à partir du contenu de la réclamation et de l’historique du compte, via un service d’IA externe, tandis que le gestionnaire du dossier vérifie la recommandation avant son envoi » est une information que l’on peut réellement gouverner.
Mais la tâche en elle-même n’est qu’un point de départ. Dans un modèle de processus, chaque tâche est reliée au contexte métier qui l’entoure, et l’introduction de l’IA modifie ce contexte en même temps que la tâche elle-même. C’est là que le véritable impact devient visible. Vu sous cet angle, les effets de l’IA vont bien au-delà de la valeur ajoutée qu’elle crée. Ils se manifestent par une évolution des responsabilités et une modification des profils de risque. Ils apparaissent également dans les contrôles qui cessent progressivement de détecter les problèmes pour lesquels ils avaient été conçus. Quelques exemples permettent de concrétiser cela.
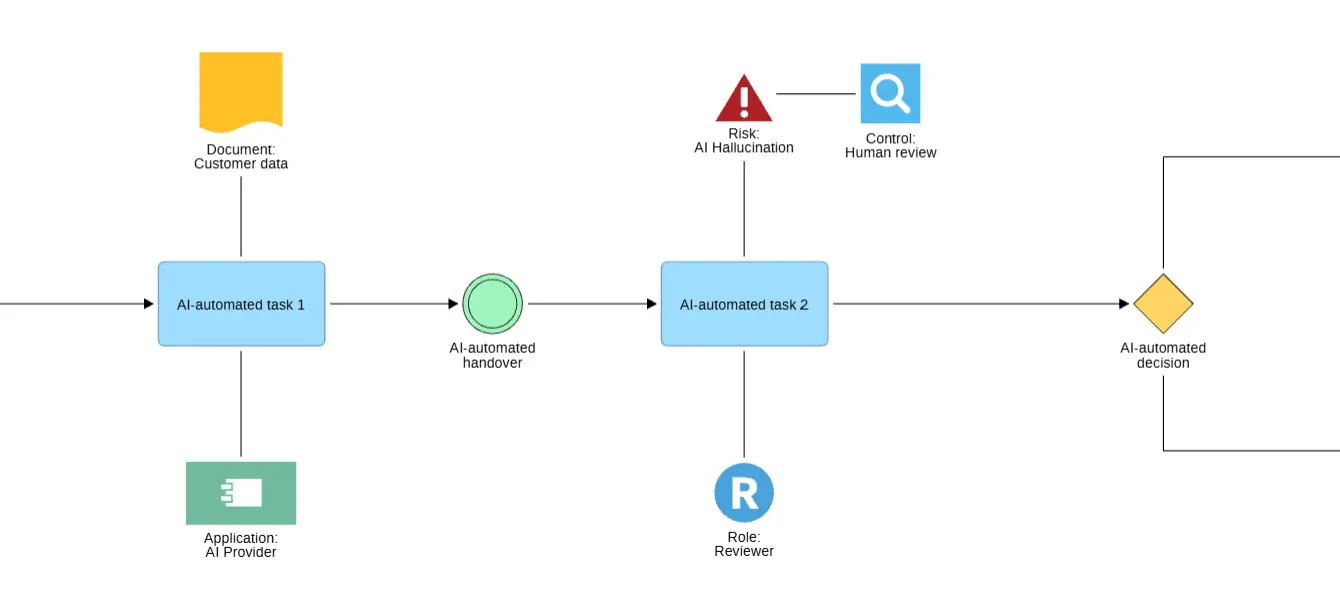
Vue d’ensemble des processus assistés par l’IA
Données
Les données elles-mêmes n’ont pas changé, mais leur niveau d’exposition, lui, a changé. Un collaborateur qui consulte le dossier d’un client est dans une situation fondamentalement différente d’un modèle d’IA qui ingère ces mêmes données — et les risques associés sont eux aussi différents.
Applications
L’adoption de l’IA introduit un nouveau type de dépendance. Le modèle utilisé pour réaliser une tâche devient une composante de l’architecture d’entreprise, avec ses propres coûts, ses risques de sécurité et ses risques liés au fournisseur. Mais la question va plus loin qu’une simple interruption de service : l’accès peut être retiré par décision, et pas seulement interrompu à la suite d’une défaillance. Des fournisseurs ont déjà restreint l’accès à leurs API dans certaines régions, tandis que les gouvernements considèrent de plus en plus l’accès aux technologies d’IA avancées comme un élément qu’ils peuvent contrôler par la réglementation.
C’est pourquoi la souveraineté de l’IA, — c’est-à-dire le contrôle des modèles, des données et de l’infrastructure dont une organisation dépend — est devenue une préoccupation au niveau des conseils d’administration. Cette dépendance est en outre difficile à supprimer, car de nombreuses organisations trouvent très difficile de changer de fournisseur d’IA. Un processus qui devient progressivement dépendant d’un modèle externe hérite donc de l’ensemble de ces contraintes, généralement sans que personne n’ait réellement décidé qu’il devait en être ainsi.
Risques
L’IA introduit ses propres risques : hallucinations, dérive des modèles, biais dans les résultats, indisponibilité des fournisseurs. Mais surtout, elle modifie le profil de risque de tâches qui comportaient déjà des risques opérationnels avant l’arrivée de l’IA. La discussion passe ainsi d’une affirmation peu utile — « l’IA est risquée » — à une question réellement exploitable : quels risques ont changé, pour quelles tâches et dans quelle mesure ?
Contrôles
Un contrôle conçu pour détecter une erreur humaine ne permettra pas nécessairement de détecter une erreur produite par une machine. Une vérification à quatre yeux permet de repérer les erreurs humaines, mais elle peut passer à côté d’un résultat généré par l’IA qui paraît parfaitement plausible tout en étant incorrect. Plus le résultat semble fluide et convaincant, moins le contrôleur risque de le remettre en question de manière critique. Le contrôle continue alors d’être validé lors de l’audit, alors même qu’il ne protège plus contre le risque pour lequel il avait été conçu. C’est pire que l’absence de contrôle, car cela crée une fausse impression de sécurité.
Rôles
Les rôles évoluent plutôt qu’ils ne disparaissent: les collaborateurs passent du rôle d’exécutant à celui de contrôleur, et de celui qui réalise une tâche à celui qui supervise son exécution. Il s’agit là d’un véritable changement en matière de compétences requises, bien au-delà d’une simple évolution de l’intitulé du poste. C’est également la direction vers laquelle convergent les régulateurs à l’échelle mondiale. Le règlement européen sur l’IA (AI Act) en constitue un exemple : il exige que la supervision des systèmes à haut risque soit confiée à une personne identifiée, disposant d’une réelle capacité à intervenir et à passer outre le système lorsque cela est nécessaire. Une simple implication humaine sur le papier n’équivaut pas à un réviseur doté de l’autorité et de l’indépendance nécessaires pour remettre en cause une décision.
Déroulement du processus
L’adoption de l’IA ne se limite pas à modifier les éléments connectés à un processus. Elle transforme également la manière dont le travail circule entre ces éléments. Lorsque l’IA automatise des tâches adjacentes, les transitions entre celles-ci disparaissent souvent. Si cela peut réduire le temps de cycle, cela peut également supprimer un point de contrôle informel qui permettait auparavant de détecter certains problèmes avant qu’ils ne se propagent davantage. Le pouvoir de décision passe également progressivement des personnes aux systèmes, ce qui rend indispensable de déterminer qui reste responsable de ces décisions, en particulier à mesure que les organisations évoluent vers l’IA agentique.
Rien de tout cela ne doit rester implicite. Les tâches peuvent être classées selon leur niveau de maturité en matière d’IA et reliées au fournisseur qui les sous-tend, de manière à les rattacher au contexte métier plus large dans lequel elles s’inscrivent.
De la compréhension des processus au déploiement de l’IA à grande échelle
La véritable puissance du BPM réside non seulement dans la visibilité de l’IA, mais aussi dans sa mesurabilité. Une fois que les attributs liés à l’IA font partie intégrante du modèle de processus, les organisations peuvent aller au-delà de la simple documentation de l’utilisation de l’IA pour comprendre comment l’adoption de l’IA progresse et où l’attention de la gouvernance est nécessaire.
Les relations présentées dans la section précédente ne se limitent plus à une simple documentation statique. Les organisations peuvent étiqueter les objets de processus en fonction de leur maturité en matière d’IA, de la supervision humaine requise, du fournisseur d’IA, de la criticité de la décision ou des coûts d’exécution. Cela permet d’identifier, d’analyser et de gouverner l’adoption de l’IA à l’échelle de l’ensemble des processus.
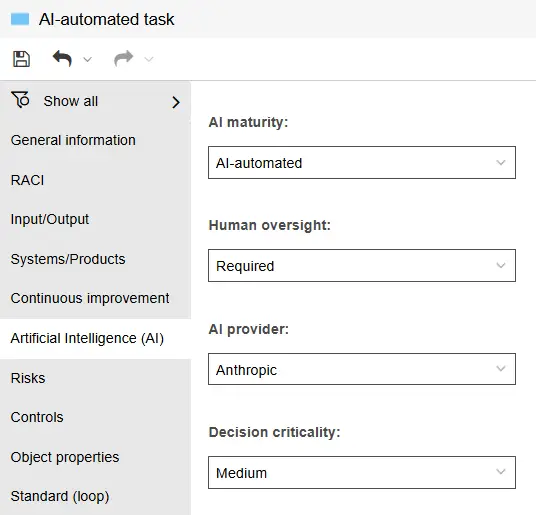
Exemple d’attributs d’IA associés à une tâche
Cela permet de poser des questions auxquelles un simple inventaire de l’IA ne peut répondre :
- Maturité de l’IA : quelles tâches sont encore entièrement manuelles ? Quels processus utilisent déjà l’IA ? Où opèrent les agents IA autonomes ?
- Supervision humaine : quelles décisions prises à l’aide de l’IA nécessitent encore une validation humaine ? Où l’IA fonctionne-t-elle sans supervision ?
- Fournisseurs d’IA : quels fournisseurs externes d’IA sont utilisés au sein de l’organisation ? Quels processus métier dépendent d’un fournisseur spécifique ?
- Importance stratégique des décisions : quelles décisions prises avec l’aide de l’IA ont le plus grand impact sur l’activité ? Lesquelles nécessitent la gouvernance et la supervision les plus strictes ?
- Coût d’exécution de l’IA : quel est le coût moyen lié à l’IA pour l’exécution d’une tâche ? Où la consommation de jetons peut-elle être optimisée pour améliorer la rentabilité ?
Rendre l’impact de l’IA exploitable avec ADONIS
ADONIS aide les organisations à faire passer l’adoption de l’IA du stade d’expériences isolées à celui d’une capacité métier stratégique et gouvernée. Comme toutes ces informations sont intégrées au modèle de processus, les organisations peuvent analyser l’adoption de l’IA sous de multiples angles – depuis les tableaux de bord de direction jusqu’aux activités individuelles des processus.
Quelle que soit la perspective adoptée, chaque initiative d’IA engendre des coûts, et rarement uniquement ceux qui sautent aux yeux. La véritable question est de savoir si la valeur qu’elle crée justifie l’investissement qu’elle implique. Sans une vision claire de ces deux aspects, cette réponse reste une simple supposition.
ADONIS offre cette visibilité en reliant les coûts aux tâches et aux agents IA qui les génèrent. Étant donné que ces mêmes tâches peuvent également comporter des informations sur la supervision humaine, les prestataires, le niveau de criticité des décisions et la fréquence d’exécution, les coûts ne sont pas évalués de manière isolée. Ils peuvent être évalués en fonction de ce que fait l’IA, de la fréquence d’exécution du processus et du niveau de contrôle requis par la tâche.
À partir de là, ADONIS peut reproduire le comportement du processus en conditions réelles en tenant compte de sa fréquence d’exécution, des coûts associés aux tâches individuelles et aux agents IA, ainsi que de la supervision requise pour chaque activité. Les organisations peuvent alors comparer un processus existant (état actuel) avec des variantes proposées (état futur) assistées par l’IA avant que les changements ne soient mis en œuvre. En combinant la fréquence du processus, les coûts au niveau des tâches, les coûts d’exécution de l’IA et les gains d’efficacité attendus, les organisations disposent d’une base structurée pour estimer le retour sur investissement potentiel. Le retour sur investissement (ROI) devient moins un bilan établi a posteriori qu’une décision éclairée prise avant l’investissement et la mise en œuvre.
Au niveau du paysage des processus, ADONIS offre également une vue d’ensemble de la maturité de l’IA dans l’ensemble des domaines d’activité. Au lieu d’examiner les processus un par un, les décideurs peuvent voir immédiatement quelles capacités restent largement manuelles, où l’adoption de l’IA progresse déjà et où se trouvent les opportunités les plus prometteuses d’amélioration.
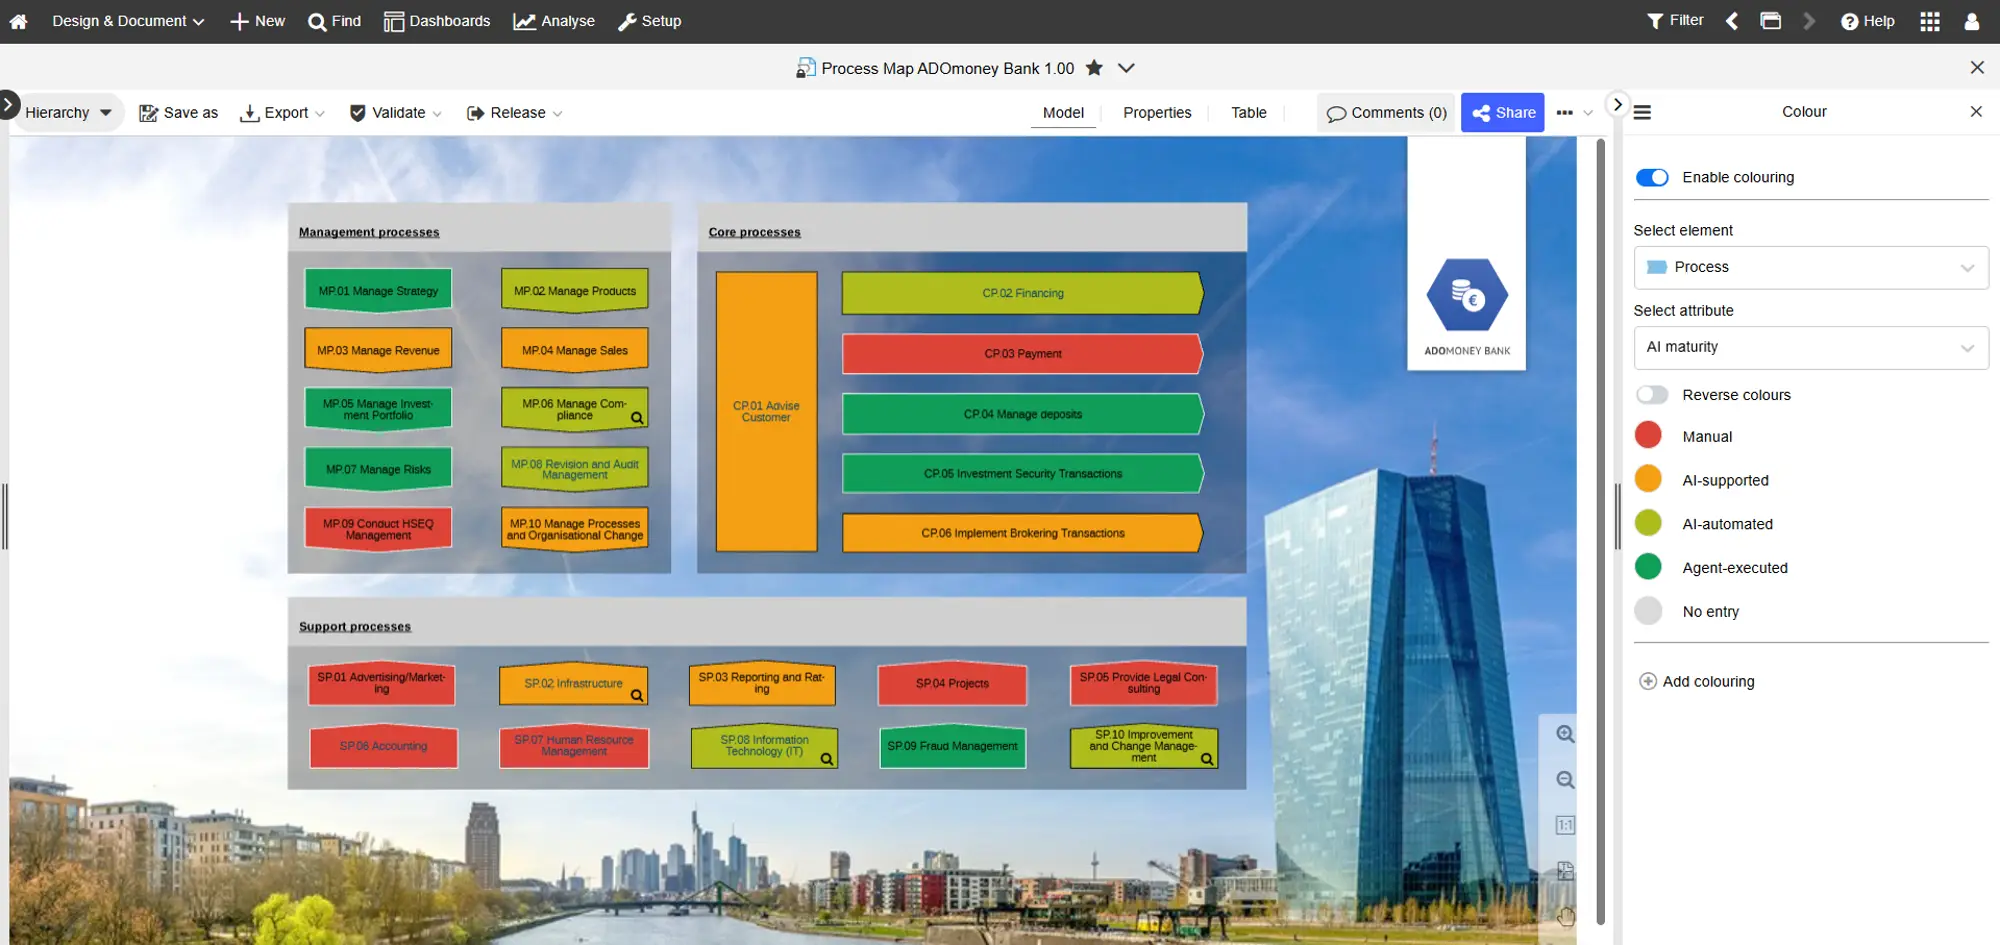
Vue d’ensemble des processus en fonction de leur maturité en matière d’IA
Les risques qui comptent se manifestent rarement dans une seule dimension. Une tâche fonctionnant de manière autonome ne pose pas de problème tant qu’elle ne traite pas de données sensibles, ne prend pas de décision critique et ne repose pas sur un seul fournisseur. C’est pourquoi ADONIS combine plusieurs attributs de l’IA dans une seule vue, en représentant la maturité en fonction de la criticité de la décision et en codant les processus par couleur, afin que les combinaisons dangereuses apparaissent clairement au lieu de rester dissimulées dans des rapports distincts. Une tâche hautement autonome traitant des données sensibles, ou une décision critique pour l’entreprise exécutée sans possibilité d’intervention humaine, apparaît clairement sur le graphique plutôt que de devoir être recherchée manuellement.
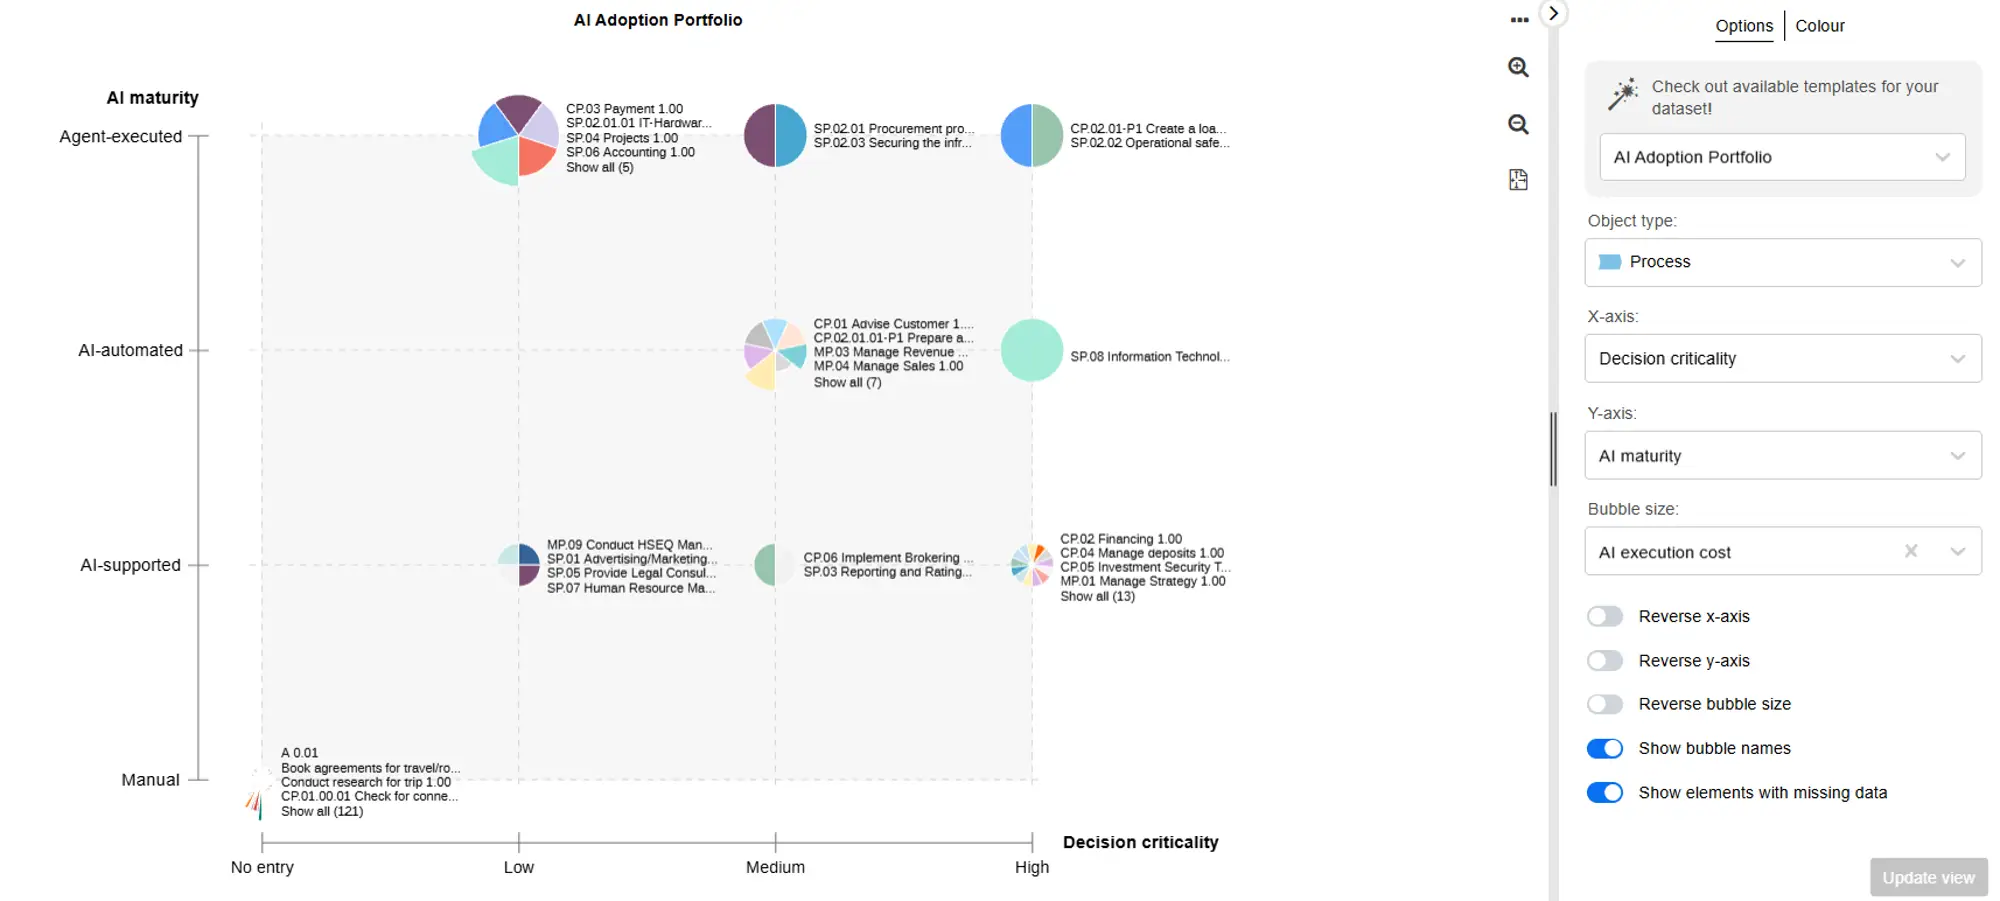
Portefeuille d’évaluation de l’adoption de l’IA
Ces mêmes liens transforment un problème lié à un fournisseur en un problème soluble. Chaque tâche d’IA s’appuie sur une application, et chaque application comporte ses propres risques et contrôles. Ainsi, lorsqu’un fournisseur ne respecte pas une exigence de conformité ou de protection des données, vous n’avez pas à vous lancer dans une recherche manuelle pour identifier ce qui est affecté. Vous suivez le lien : tous les processus dépendant de ce fournisseur s’affichent d’un seul coup, avec leurs risques et leurs contrôles associés, et vous pouvez chiffrer le coût du changement et modéliser une nouvelle variante de processus avant de vous engager. La dépendance vis-à-vis d’un fournisseur cesse d’être un piège et devient un élément que vous pouvez visualiser, chiffrer et remplacer en toute fluidité.
Transformer la transparence de l’IA en meilleures décisions
Savoir où l’IA intervient n’a d’intérêt que si cela change ce que l’on décide ensuite. Dans ADONIS, cette visibilité alimente directement les décisions, car le même modèle est déjà connecté à tous les éléments sur lesquels repose une décision : les applications sous-jacentes à un processus, les données qu’il utilise, les risques qu’il comporte et les contrôles destinés à les détecter, jusqu’au niveau de la tâche. Tout attribut d’IA dont vous avez besoin peut être introduit là où il a sa place, que ce soit au niveau du processus, de la tâche, de l’application, du risque ou du rôle, en fonction des besoins de votre entreprise.
Cela vous offre une vue d’ensemble du paysage jusqu’à la moindre étape, et une base concrète pour déterminer quels processus sont véritablement les mieux adaptés à l’IA, plutôt que simplement les plus visibles.
À partir de là, les décisions s’appuient sur des données concrètes plutôt que sur des suppositions. La même visibilité qui montre où l’IA crée de la valeur révèle également où elle risque de rencontrer des difficultés, ce qui transforme une question telle que «où investir» ou «où se développer» d’une simple intuition en une décision fondée sur des preuves. Elle met également en évidence les choix les plus difficiles : lorsqu’une tâche doit être repensée avant même que l’IA n’intervienne, lorsqu’un contrôle conçu pour les erreurs humaines doit être repensé pour les erreurs machines, et lorsque la bonne réponse est de s’arrêter, une option que personne n’est aujourd’hui en mesure de justifier. Les scénarios peuvent être testés avant la mise en œuvre plutôt que découverts après la mise à l’échelle : une référence manuelle comparée à une version assistée par l’IA, ou à une version prise en charge par un agent. La même vision qui met en évidence les risques met tout aussi clairement en évidence les opportunités.
Tout ce qui est défini au niveau de la tâche – quelle étape nécessite une vérification humaine et laquelle peut s’exécuter de manière autonome – cesse d’être une documentation que personne ne lit. Grâce au MCP, un agent récupère ces connaissances au moment de l’exécution et agit selon les règles applicables à l’endroit où il intervient. Cela comble précisément la lacune laissée par le deuxième facteur, où la direction pouvait choisir le bon processus mais ne parvenait jamais à transmettre ses exigences à chaque tâche. Avec le MCP, ces exigences accompagnent enfin le travail lui-même.
Savoir où l’IA est déployée, voir ce qu’elle fait et explorer son implantation au sein de l’organisation est un besoin en soi, et c’est précisément à cela que sert le cockpit. Comme les tableaux de bord sont configurables, ils s’adaptent à la personne qui les consulte. La direction dispose d’une vue d’ensemble sur un seul écran : où l’IA opère au sein de l’organisation, les applications et les fournisseurs qui la sous-tendent, les risques liés à ces processus, et qui est responsable de chaque utilisation. Un collaborateur voit son propre domaine de responsabilité : les tâches dont il a la charge, l’IA et les données concernées, ainsi que les moments où il est censé les vérifier et intervenir. Dans tous les cas, chaque tâche assistée par l’IA est associée à une personne désignée, de sorte que l’IA, qui fonctionnait autrefois à l’insu de tous, devient une partie visible et assumée du processus.
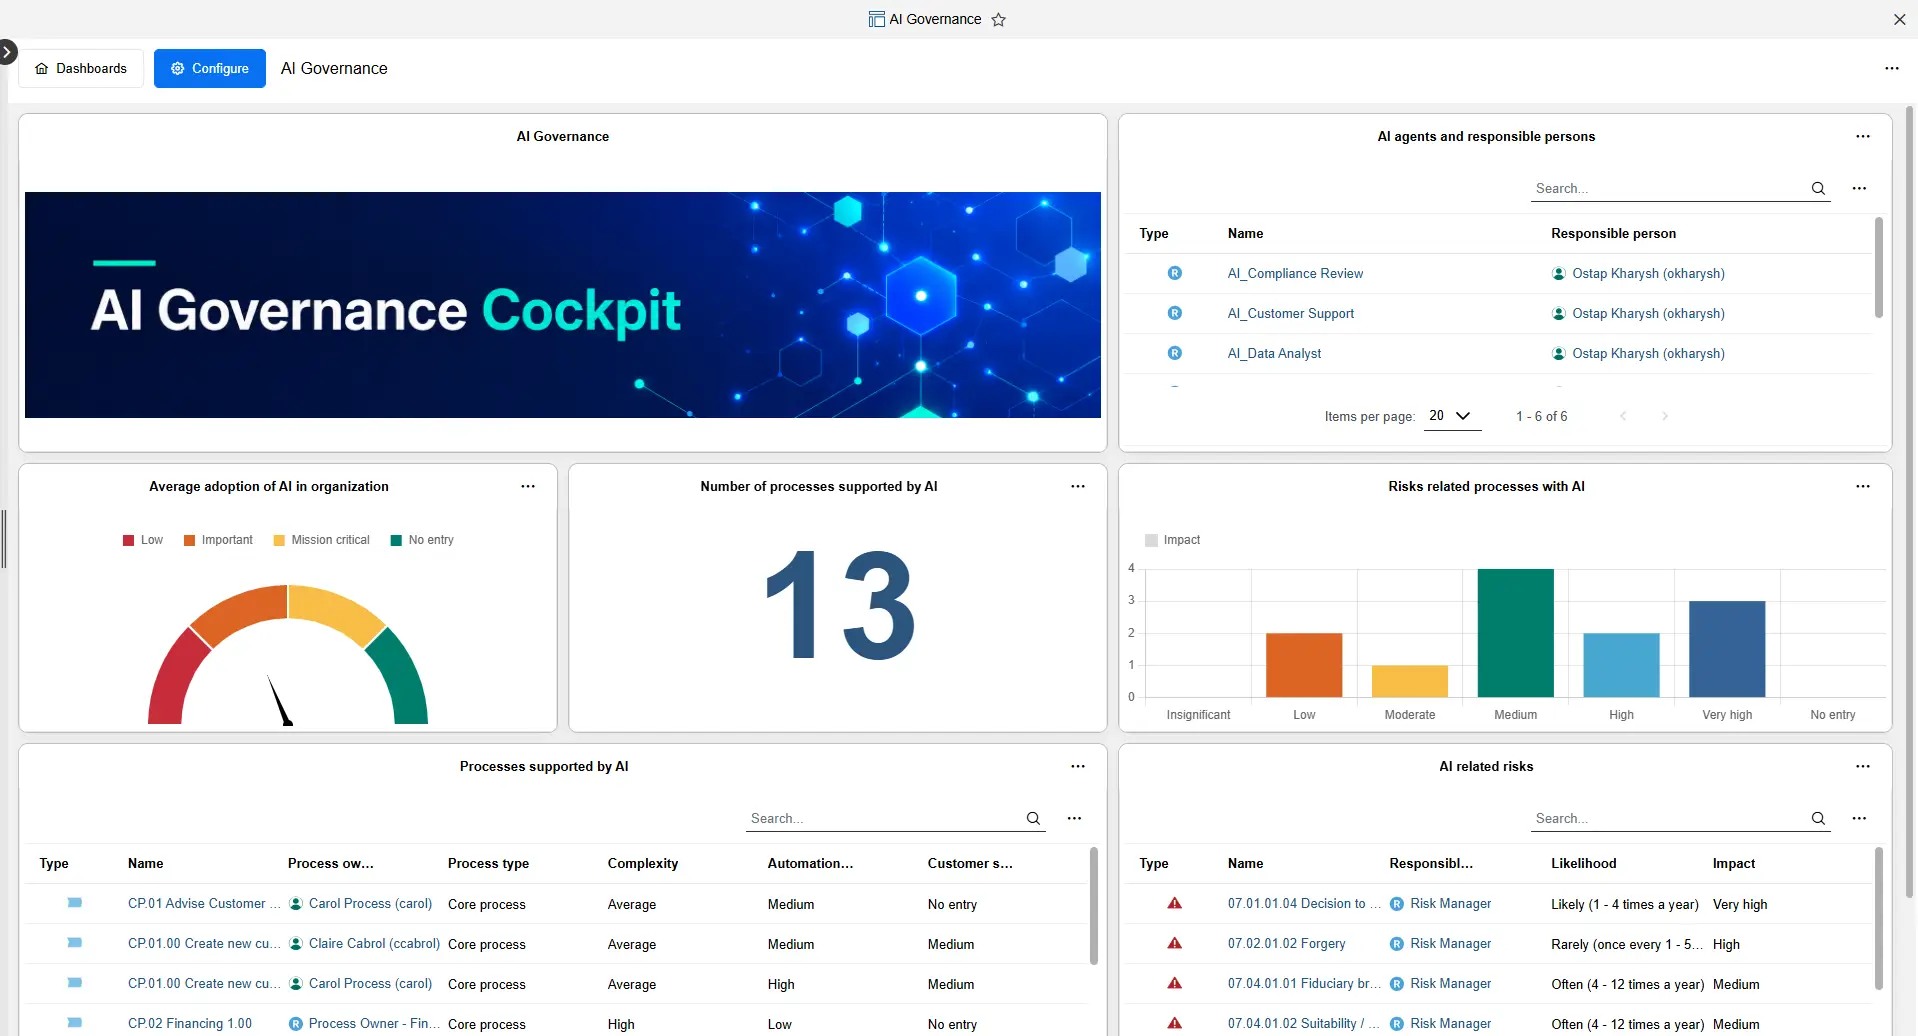
Cockpit de gouvernance de l’IA
La décision prend ainsi une autre dimension. « Pouvons-nous utiliser l’IA ici ? » est une question de capacité, et la réponse est presque toujours oui. « Devrions-nous utiliser l’IA ici, et comment le faire de manière responsable ? » est une question de valeur, de risque et de responsabilité, dont l’impact est mesurable avant que quiconque ne donne son accord.
Avec ADONIS, les organisations peuvent s’appuyer sur des capacités d’analyse fiables pour évaluer l’impact de l’IA sur n’importe quel processus, et décider où investir, développer, repenser ou faire évoluer leurs activités.
Résumé
Dans la plupart des organisations, l’adoption de l’IA a déjà dépassé le stade de la simple question de savoir s’il fallait l’autoriser. Les collaborateurs ne cessent de découvrir des outils qui accélèrent leur travail, tandis que la direction continue de rechercher les processus où l’IA est la plus rapidement rentable. Ni les uns ni les autres ne vont s’arrêter, et ils ont raison de ne pas le faire.
Ce qui distingue les organisations qui tirent une réelle valeur de l’IA de celles qui en sont encore au stade des projets pilotes se résume à une seule chose : leur capacité à visualiser l’impact de l’IA sur une tâche spécifique, les données qu’elle traite, les risques qu’elle modifie, son coût de fonctionnement, le fournisseur sur lequel elle s’appuie et la personne qui reste responsable du résultat. Un inventaire d’outils ne peut pas vous montrer cela. Un modèle de processus le peut, car la tâche, les données et les risques en font déjà partie.
C’est ce qu’ADONIS met à la disposition des organisations. Le modèle de processus qu’elles gèrent déjà devient le lieu où l’IA est conçue, chiffrée, mesurée et corrigée, et non un système distinct qui suit l’IA en parallèle.
D’une manière ou d’une autre, l’IA continuera à s’immiscer dans le travail. La question qui reste en suspens est de savoir si un membre de l’organisation peut affirmer, preuves à l’appui, ce qui a changé, comment cela s’est produit et qui en est responsable.


Vous avez déjà reçu nos dernières actualités de la semaine ?